细分场景原声馆
#数学思维
围绕「数学思维」从 2 亿+ 原声数据中提炼的精选纪录片。也可以在下方输入更具体的问题,30 秒现剪新片。

大家都知道,但没人说破:共同知识如何决定合作
MIT 的讲座把共同知识当作需要精确定义的假设,史蒂文·平克则给出递归检验:我知道你知道,如此不断延伸。Freakonomics 补上演化协调,Diamandis 与 Graylin 把美中竞赛称为猎鹿博弈。这些材料把相关说法连到协调博弈、高阶信念与信任。

囚徒困境的真正解法:把游戏玩下去
囚徒困境是一个简洁模型,用来说明理性自利如何造成两败俱伤。YaleCourses指出,事先沟通常常无法保证合作;卡内基梅隆大学的审讯例子和Vsauce2对告密的分析,让背叛成为占优策略。Diamandis提出不同看法:世界是多回合的。重复博弈研究追问,不确定性、不对称和声誉能否让合作变得理性。

个人品牌已经失效?真正管用的打法
个人品牌的难点在证明,不在包装。Sunny Lenarduzzi 指出,AI 和不露脸频道正涌入信息流;Omar Eltakrori 反复回到竖屏短片;Joanna Wiebe 强调内容心理学;Barbra Gago 把品牌与分析机构认可的品类绑定。相关文献在差异化和认知上看法一致,但各位实践者对先要触达还是先要品类权威仍有分歧。
看得见的数学,也会用图骗你
桑德森把视觉直觉当作实用工具:他改写底数,画出导数,在代数与几何之间来回移动。莱克斯·弗里德曼通过表情包评论呈现同一种习惯,尤金妮亚·程则提醒直觉可能被操纵。伯克利·哈德森2013年的文章和一篇 PULSCAR 可视化论文表明,这套方法已流传到 YouTube 之外。

你的直觉,其实是个糟糕的统计师
贝叶斯定理给出反转条件概率的规则,讲者将其视为实用的信念更新。3Blue1Brown把这一想法锚定在卡尼曼和特沃斯基的工作上;史蒂芬·平克呼吁校准的置信度;耶鲁和麻省理工则勾勒先验、证据与策略均衡。阿姆斯特朗2023年的研究记录了年轻人和老年人在信念更新中的偏差,而编程和统计部分则展示这条规则如何进入课堂和软件。

陶哲轩的直觉校验:好证明,往往先于逻辑
这份档案沿一条务实的线索展开:直觉靠练习、面试和明确检查建立起来。3Blue1Brown 讲的是用程序做直觉校验;Utsav 把技巧和面试演练绑在一起;Kwik 指出压力会切断执行性解题能力的通道。陶哲轩 2006 年关于数学问题解决与数学成熟度的工作提供了文字骨架,人工智能在证明上的进展则让判断变得更要紧。

创作者经济的硬账:谁在分钱,谁在陪跑?
创作者经济看起来像一架分层阶梯:订阅、赞助和平台抽成。卡米尔·赫斯特讲的乔布斯轶事把利害关系说得很具体,因为每一层变现方式都要求创作者讲清楚自己到底做什么。来自VidCon、《财富》、TBPN、Edwards Economics和《Vogue Business》的报道显示,不同市场面临同一种压力;关于关系劳动和可持续变现的学术研究则补上了缺失的结构。

选票必须保密,数学却能证明它被数过
MIT 的讲座把同态加密称为一种数学思想;Numberphile 把它变成选民的验证问题。MongoDB 的 Joel Odum 与 AES 评论把产品实践和批量加密区分开。Samantha Lowrimore 警告,更快的机器会改变安全假设,而关于 AES、RSA、格与椭圆曲线方法的资料勾勒出技术基础。

五个至今无解的悖论,专治常识不服
耶鲁的讲座点出孔多塞投票悖论,肯尼斯·阿罗的不可能定理则解释,为什么排序式的集体选择会违背基本的公平公理。Minutephysics 和莱克斯·弗里德曼展示了测量与自指领域的相邻悖论;Smarter Every Day 和芝诺的叙述则让箭在字面和时间两个层面出现。布莱克的中位选民定理标出一条狭窄的一维路径,通往稳定结果。

AI 写出的数学证明,人类已经读不懂了
图多尔·阿希姆说,AI将用Lean写证明供计算机核查;TBPN和a16z则描述快速进展和高难度天花板。All-In和TWiT关注人类影响与怀疑态度,《新科学家》指出这项工作背后的结构化数据。零知识证明和陶哲轩有助于区分形式验证与数学深度、公众信任,这一差距框定了难度争论。

23个人就有一半概率撞生日,你的直觉为什么算不过来
生日问题问的是,在一组随机人群中,至少两个人同一天生日的概率有多大。Numberphile用对数讲解数学,把乘积变成求和;Vsauce2从23个婴儿讲起;Computerphile把同样的计数连接到哈希碰撞。SLICE Science点出70个人与366个可能日期之间的落差,经核实的参考资料则确认了这个反直觉的定义。
四色就够,但人类还能亲手证明吗?
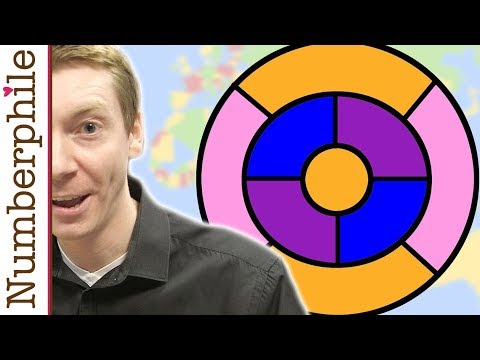
Numberphile 把四色定理表述为一个简单的给地图上色的问题。MIT OpenCourseWare 把地图着色放进图论。牛津的 Jason Lotay 提到计算机证明,也提到避开计算机的设想。书面记录确认了该定理、较容易的五色结果,以及近年经过同行评议的无计算机证明尝试。争议在于什么才算令人满意的证明。
现实只是流动的数学吗?沃尔弗拉姆与弗伦克尔追问观察者
数学行之有效,但几位讲述者对原因意见不一。弗伦克尔的爱因斯坦轶事把思考展现为身体化的日常习惯;沃尔弗拉姆和 Beeyond Ideas 的讲述者把观察者和大脑当作数学过程;引力钟让抽象落到物理层面。莫里森关于物质性的研究提醒,模型并不穷尽现实,因此描述可以成功,却不必把问题封死。

那场对话,为何在你脑中循环
这份专题关注的是预期担忧与事后回放之间的缝隙。一位讲述者描述了活动前持续数日的恐惧;另一位把转变形容为顺其自然。心理学文献把反刍定义为对负面想法的持续重复,余下几段则呈现公共事件:恐慌被管理,或被暴力击碎。对任何会反复回放社交失败的人来说,这种对照有现实意义。

鹳鸟不送子:数据是怎么骗过聪明人的
这份档案把 Numberphile 的鹳鸟与婴儿故事,放在 Study Hall 的土地记录、Udacity 关于工具变迁的论证,以及经核实的辛普森悖论定义旁边。这些片段并不都在直接谈聚合,但它们说明,读取趋势时,记录、分组和计算方式为什么重要。这个悖论提醒人们:该信任哪张表,该做哪种比较。

存得越多,走得越早:储蓄率才是你的退休倒计时
储蓄率把收入变成一个留下来的数字:Humble Penny 问你能留下多少,Asian Dad Energy 把50%的储蓄率看作裁员缓冲,Gabrielle 从预算里读出28%。Nick Invests 指向计算器;PensionCraft 找到英格兰银行的储蓄率栏目。Summers 谈税收政策与回报,加上日本的家庭数据,说明储蓄率对政策敏感,个人因素只是其中一部分。

99%的AGI幻觉:基准测试究竟证明了什么
这些片段把 ARC AGI 既当作北极星,也当作记分牌:99% AGI、Gemini 3 Deep Think 的 84%、Grok 4 的推理主张。文字资料对 GPT 和 AGI 给出宽泛定义,一篇 AGI 基准论文则强调测量的局限。Alex Ratner 关于红队的说法,指向评估背后的机构性工作。