01
先講直覺,再講公式
3Blue1Brown 一開場就承諾不碰公式,先帶人走一遍;StatQuest 接著給出逐條曲線的機制:把藍色曲線和橙色曲線相加,加上偏置 b3,再調整。書面資料說得更直白:反向傳播是一種用於訓練神經網路的梯度計算方法。兩位講述者的語氣不同,目標卻一致。一個先搭直覺,另一個講引數更新的算術。
兩位科普者都把反向傳播視為學習的核心更新規則。
How Machines Learn: The Hidden Lineage Behind ChatGPT
從1943年的論文到二十二個字的警告,五段故事串起神經網路如何學會學習。
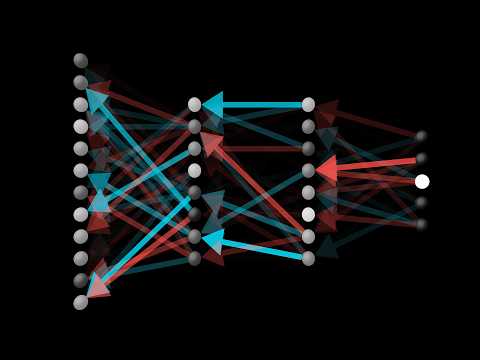
ACT I · 3Blue1Brown · 5m 21s
不用一個公式講懂反向傳播
這裡我們講反向傳播,這是神經網路學習的核心演算法。
Here, we tackle backpropagation, the core algorithm behind how neural networks learn.
3Blue1Brown 承諾先不寫公式,用直覺帶人走一遍反向傳播。
30 秒速查核心結論 · 一手原聲提煉
5 幕 · 2 份文獻 · 最近核驗 Nov 21, 2026“反向傳播是一種梯度方法,但公眾敘事常從辛頓講起,一直講到今天的聊天機器人。”
全片核心結論
3Blue1Brown 把反向傳播從公式裡剝出來,StatQuest 則沿著曲線和偏置一步步演示。Louisa Nicola 把起點指向 1943 年,《泰晤士報》採訪辛頓,AI Explained 追蹤一份 22 個單詞的安全宣告。這些內容合在一起,呈現出一條線索:梯度計算、神經網路訓練,以及一場圍繞風險的公共爭論,而這場爭論如今正包圍著那些讓這個領域變得可理解的人。
3Blue1Brown 一開場就承諾不碰公式,先帶人走一遍;StatQuest 接著給出逐條曲線的機制:把藍色曲線和橙色曲線相加,加上偏置 b3,再調整。書面資料說得更直白:反向傳播是一種用於訓練神經網路的梯度計算方法。兩位講述者的語氣不同,目標卻一致。一個先搭直覺,另一個講引數更新的算術。
《泰晤士報》把傑弗裡·辛頓介紹為人工智慧先驅,訪談形式也讓他從這一位置發言。Louisa Nicola 不接受“教父”這個標籤:ChatGPT、Claude、Gemini,每一項突破都能追到 1943 年。外部記錄確認了辛頓在神經網路上的工作,也確認了他獲得諾貝爾獎,但這些記錄並沒有抹掉更早的數學家。爭論落在譜系和功勞上,不在反向傳播能否訓練網路。
AI Explained 報道,產業領袖、專家和學者釋出了一份 22 個單詞的宣告,呼籲把人工智慧安全列為全球優先事項。辛頓與蘇茨克維等人一起出現在這場公共討論中。轉變很直接:一個用曲線和偏置講清楚的演算法,成了政策議題。與此同時,Michael Crist 在 PyData 演講中把基於反向傳播的系統當作人類認知的模型,這是另一項主張,也讓任何簡單的安全共識變得更復雜。
順著這條線索繼續追問
全片完整時間戳雙語逐字稿
如果想用電影短句練習口語連讀、道地俚語或日常跟讀,我們的姊妹工具 WinkLingo 專注於影視級逐句精聽與日常英文表達訓練。
深度問答與核心摘要
3Blue1Brown 把反向傳播從公式裡剝出來,StatQuest 則沿著曲線和偏置一步步演示。Louisa Nicola 把起點指向 1943 年,《泰晤士報》採訪辛頓,AI Explained 追蹤一份 22 個單詞的安全宣告。這些內容合在一起,呈現出一條線索:梯度計算、神經網路訓練,以及一場圍繞風險的公共爭論,而這場爭論如今正包圍著那些讓這個領域變得可理解的人。 核心要點包括:3Blue1Brown 承諾先不講公式,用直覺帶人走一遍反向傳播,並把這一演算法說成神經網路學習的核心機制。;StatQuest 講到把藍色和橙色曲線相加,再加上最後的偏置 b3,說明反向傳播是逐步調整引數,不必把它看成抽象數學。。
本片共剪輯 5 幕連播原聲章節,涵蓋 3Blue1Brown、StatQuest with Josh Starmer、TNE with Louisa Nicola、PyData、AI Explained 等獨立信源,並清晰標註「一手原聲 / 權威報道 / 獨立評述」出處與精確時間戳,點選逐字稿任意一句即可直接跳播。
主要共識:反向傳播是一種用於訓練神經網路的梯度計算方法。。 關鍵張力與分歧:Louisa Nicola 的 1943 年譜系挑戰“教父”框架,《泰晤士報》的訪談則把辛頓放在先驅的位置上。。
在播放器下方切換「時間戳雙語逐字稿」即可閱讀全部雙語對照臺詞並一鍵匯出 Obsidian / Notion 筆記;右側「權威文獻與背景佐證」彙總了 2 份外部參考(如《Backpropagation》等)供核驗。

Microsoft Mechanics 問企業如何擴充套件智慧體架構,同時不繞過安全與控制。NVIDIA 用 OpenShell 和 Century 作答:一個硬體隔離的可信域,用來監控推理流量。Cole Medin 強調專業能力的組合,DM Radio 強調提示上下文,劍橋大學強調居民參與。AI 智慧體可以自主追求目標,OpenAI Codex 已經在編輯程式碼、修復缺陷。規劃因此成為圍繞控制、上下文與合法性的較量。

開源 AI 重新分配責任,並未取消責任。Clem Delangue 和 Yann LeCun 把開放視為對權力集中的制衡,CNBC 的一種聲音則警告,擴大開放模型規模很危險。NVIDIA 的機器人演示顯示,使用者在系統部署後繼續訓練;OpenAI 的 PBC 與失控智慧體報道說明,封閉實驗室仍要面對直接問責,Jerry Murdock 則談到市場生存壓力。

這份檔案追蹤 CRISPR 的軌跡:從 CASGEVY 獲 FDA 批准,到阿西洛馬指南,再到賀建奎事件。CNBC 報道了一種治療兩種遺傳性血液病的療法;彭博社回顧1975年之後科學家如何寫下倫理規則。艾薩克森和 Big Think 把 DNA 放在身份問題的中心,而費里斯和 CrashCourse 顯示公共討論如何漂向贊助口播和玩笑。專利糾紛一直籠罩著這項諾貝爾獎技術。

控制問題是一連串失敗疊在一起:智慧體追求目標,基準測試卻抓不住意圖;機構也無法為災難性錯誤定價。布萊恩·克里斯蒂安的訪談與 Anthropic 的專題討論都承認技術難度。The Information 和 CNBC 則顯示,在研究尚無定論之前,成本、部署與監督已經在哪些地方正面相撞。

這份檔案追蹤一份把超級智慧放在 2027 年的預測:從博斯特羅姆的基本定義,到 AI Futures Project 的研究。評論頻道承諾拆解炒作,也提醒智慧體的侷限;蒂姆·費里斯和薩姆·奧爾特曼則呈現這場競賽的文化與人的代價。現有證據足以支援一場嚴肅的預測辯論,但時間點、可靠性和制度壓力仍是未解問題。

李飛飛的工作,從為影像貼標籤走向為影像奠基:ImageNet 教會機器識別,而空間智慧要求機器在三維世界中感知、推理並行動。她並不宣稱人工智慧已經抵達終點,而是說艱難的一步,生成帶有空間語境的畫素,正在發生。面對勝利主義,她讓科學保持謙遜,也對代際評判保持警惕。本檔案將這種紀律讀作一種實踐倫理:建造理解真實世界的系統,並保持好奇,足以知道自己仍看不見什麼。